客服人力怎麼估?用來訊量與處理時間安排班表
從每小時來訊量、平均處理時間與同時在線負荷,逐步試算客服人力,並用尖峰備援和每週校正安排更合用的班表。
安排客服班表時,容易遇到一種落差:整天總量看起來不高,某些時段卻忙到回覆堆積。估人力要先看需求落在哪一小時,再把案件換算成實際處理分鐘,最後檢查同時在線工作、休息交接與尖峰備援。以下用明確標示的假設數字示範算法;實際排班仍要以自己的紀錄與服務目標校正。
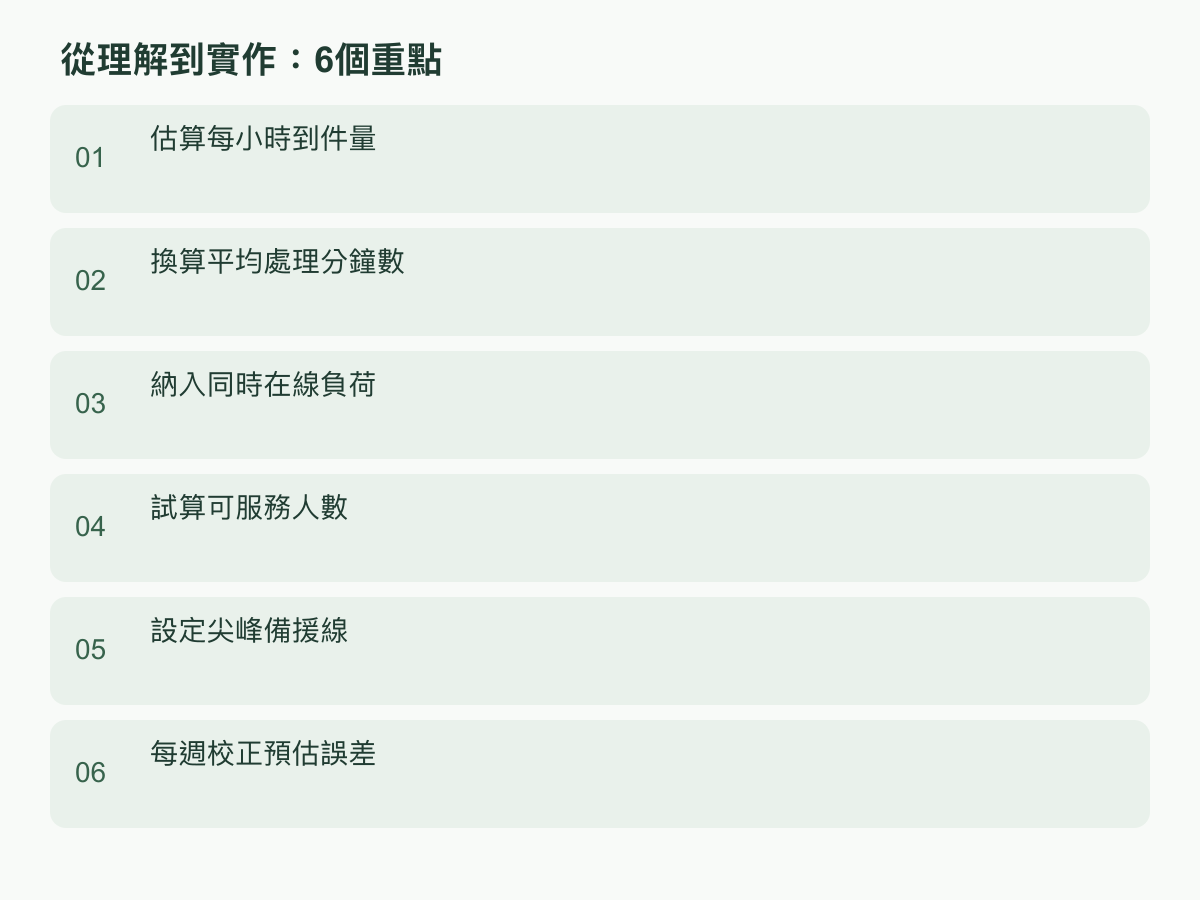
估算每小時到件量
先把「到件」定義成一個需要處理的客服案件,而不是對話中的每一則訊息。同一個需求裡顧客連續補充資料,通常仍計為一件;結案後另提出新問題,才另開案件。先固定這個口徑,才不會把同一位顧客的追問重複算成好幾件,讓預估人力失真。若工作流程把多個問題合併成一張案件,也要照實際分派方式記錄。
統計時以第一次收到訊息的時間歸入時段,並記下日期、管道、問題類型及是否重開。不要依結案時間分桶,跨班完成的案件會被算到後一小時。平日與週末、一般日與促銷日應分開比較;如果某個時段遇到活動或系統異常,就註明原因,避免它悄悄變成日常需求基準。若某天資料缺漏,也應標出來,不要用零件數代替。
資料可先按一小時整理,再用十五或三十分鐘切片查看流量是否集中在某一段。假設同一個平日的十點至十一點,五天收到的案件數依序為十、十四、十二、十六、十三件:
| 工作日 | 一 | 二 | 三 | 四 | 五 |
|---|---|---|---|---|---|
| 假設到件數 | 10 | 14 | 12 | 16 | 13 |
合計六十五件,除以五天,平均為每小時十三件。平均數適合作為起點,仍要保留每天的數字,查看高於平均的情況是否集中在固定日子。若週一和週五差異明顯,就分開估算;若每週都不一樣,先增加紀錄,再決定哪些日子可以互相比較。只有日總量時,也不要直接除以營業時數當作每小時需求,因為那會抹平尖峰。
換算平均處理分鐘數
到件量說明有多少工作進門,平均處理時間則把案件換成客服實際投入的人力分鐘。可把閱讀需求、查資料、撰寫回覆、必要紀錄與結案操作納入;顧客等待、隔夜未讀或系統閒置不算客服正在工作的時間。若一件事由兩位客服分段接手,應加總兩人的實際投入,不能只看最後結案者。這樣得到的數字才適合用來估算每小時的工作負荷。
計時時採用一致的起訖定義,並在一段期間抽查不同問題類型。簡單查詢、需要查訂單的個案、需要跨部門確認的案件,處理時間可能不同;只用所有案件的單一平均,容易低估複雜案件集中的班次。可先記每類案件的件數和投入分鐘,再按各類比例加權。資料量有限時,標示為初估,別把少數幾筆當成穩定平均。
假設前一節的十三件案件,每件平均需要八分鐘客服實際處理時間,那個小時的工作量就是十三乘以八,等於一百零四分鐘。這不是說一位客服能在一小時內完成一百零四分鐘工作,而是代表至少要有一百零四分鐘的人力投入,再看每人可用時間、案件是否同時到達及排班休息安排。若八分鐘只計了回覆文字,漏掉查詢和結案紀錄,計算就會低估需求。
建立時間資料時,先選定幾個容易持續記錄的欄位,例如案件類型、首次進線時間、客服投入分鐘與重開狀態。每週抽樣核對紀錄是否把等待時間算進去、是否漏掉轉手處理,也觀察平均值是否被少數複雜案件拉高。若同類案件差異很大,就分組呈現平均和常見範圍,排班時依各時段的案件組成估算,不要用一個看似精確的數字掩蓋差異。
納入同時在線負荷
人力分鐘回答的是總工作量,同時在線負荷則回答某一刻有多少案件正在等待處理或進行中。文字客服可以在多個對話間切換,但「同時開著幾個對話」不代表所需人力可以按對話數等比例減少;閱讀、判斷、查詢和寫回覆仍需要實際投入。電話或需要即時專注的案件,通常更難在處理期間切換工作,因此應分開記錄不同管道的在線限制。
估算進行中的案件數,可用每小時到件量乘上平均案件從進線到完成的經過時間,再除以六十分鐘,作為平穩狀態下的粗略參考。假設每小時十三件,平均每件從收到到結束約二十分鐘,十三乘二十再除以六十,約有四點三件同時進行。這是案件數的估算,不是客服人數;如果案件在等待客服、等待顧客或等待確認,也應在紀錄裡分開標示。
接著用實際觀察訂出每位客服可安全維持的對話數。例如試行後發現,每位客服同時照看兩件文字案件,仍能完整查證並適時回覆,四點三件除以兩件約需二點二位,因此至少排三位在線。這個例子是假設,不是通用配置;如果回覆品質下降、案件停滯或交接漏訊,就應降低並行數,而不是單靠提高每人案件上限來解決堆積。
並行數要用尖峰時段驗證,並設定觀察指標:案件等待首回覆的時間、未處理數、超過預期的進行中案件,以及客服是否需要延後紀錄。待處理案件持續增加時,實際在線工作量已超過單純平均公式的前提;即使每小時來訊數沒有增加,也要檢查回覆速度或案件處理時間是否改變。試算後將人力分鐘法與案件在線法並列,採用較高需求作為初步排班底線,再用實際班表修正。
試算可服務人數
把前兩節的數字放進公式,可以得到一個可解釋的初估:所需在線人數=每小時到件量 × 每件平均處理分鐘 ÷(六十分鐘 × 預定工作占用比例),最後向上取整。假設每小時十三件、每件八分鐘,並以內部假設的百分之八十作為可排給案件處理的時間比例,計算為一百零四除以四十八,約二點二人,需排三位在線。百分之八十只是示範用的管理假設,不是任何行業的標準。
公式中的占用比例,是為了讓客服保留必要空間處理短暫波動、紀錄與交接。若把每人的整個小時都排滿案件,少量突發個案就可能形成等待;若空出很多時間,則要確認是否為了高峰、複雜案件或服務目標保留。先用自己的歷史班次回看:當占用接近設定值時,案件等待和未結數是否仍可接受,再調整假設。不能只因為算出整數,就認定服務一定穩定。
人數要按時段計算,不要用一天的總工時除以平均需求就直接排班。先把每小時再切成十五或三十分鐘,為每格估算到件和處理分鐘,分別向上取整後檢查相鄰時段的交班重疊。若需求在十點集中、十一點下降,整點平均可能看不出十點前半段的短缺。實務上也要把午休、訓練、會議、請假和交接列入可在線人數,否則排班表上的人數會大於實際能接案的人數。
試算後,將需求數和現有班表放在同一張表裡,比對每個時段的差額。若公式需要三位、排班只有兩位,先檢查是否能把開始時間錯開、調整非尖峰工作或加入短班;若已排四位,也要確認多出的人力是否承擔其他任務。這一步的目標是找出缺口發生在哪些時段,讓調班有依據,而不是單看整天總人數判斷夠不夠。
設定尖峰備援線
平均需求無法單獨決定尖峰班表。保留同星期、同時段的每日到件數,查看高峰出現的時間、持續多久,以及是否伴隨較長處理時間。再把休息、交接、臨時缺勤和需要專心處理的案件放進同一張班表,確認每段時間實際有幾位能接新案。備援可以是錯開班別、預先留一位機動人力,或讓受訓同事在特定時段支援;要選能在需求發生時真的上線的安排。
沿用假設例子,平均每小時十三件、每件八分鐘,工作量是一百零四分鐘;若尖峰來到二十件,則是 一百六十分鐘。以每位每小時四十八分鐘的示範可用量估算,平均約需三位,尖峰約需三點三三位,向上取整為四位。這表示備援可在該尖峰時段增加一位,而不一定整天都多排一人。數字只說明算法,實際需求還得依案件並行方式與希望維持的回覆節奏確認。
備援線要能觸發,也要指定負責人。比如先把平均十三件分攤到四個十五分鐘區間,每區約三至四件;假設某區間達五件,且連續兩區都達到,值班主管就通知機動人力加入。這是可調整的假設規則,可依回覆等待和未處理量修改,不宜把單一偶發尖峰設成自動加班標準。若案件主要集中在某個管道,可讓支援者先處理已明確分類的項目,避免多人重複接手。
休息與交接也要錯開,不能把同一時段所有人都列為可接案。事先安排誰看佇列、誰接高複雜案件、支援人力何時結束,並讓下一班知道未結案件和已承諾的回覆。若備援常常啟動,代表基準班表可能已經低估需求,應回到來訊量與處理時間重新估算;若幾週都沒有啟動,也可檢查備援時段是否排得太長,將人力移到更需要的窗口。
每週校正預估誤差
每週用相同口徑比較預估與實際,不要只看整月總數。按日期、星期、時段、管道和問題類型,比較到件量與處理分鐘;再看當班人數、進行中案件、等待首回覆及延後下班情形。若預估十三件、實際十六件,件數誤差為三件;以實際十六件作分母,誤差約百分之十八點八。這是單一假設例子,重點是同時保存預估值和實際值,才能看出偏差在哪些班次重複發生。
到件估得準但仍常堆積,就檢查平均處理時間是否少算查詢、交接或結案紀錄;若處理分鐘接近預估,卻只在特定十五分鐘區間出現等待,就把排班切得更細。預估高於實際時,也不要立刻認定人力多餘,先排除促銷取消、資料缺漏或案件分類改變。當某類問題比例改變,整體平均處理時間也會跟著變,應分別校正案件件數與每件耗時,不要只改總人數。
每週留下簡短的差異紀錄:哪個時段偏差最大、可能原因、下週要改哪一格班表,以及要觀察什麼結果。可把誤差寫成實際減預估的件數,檢查是否長期高估或低估;也可計算各時段的絕對差距,找出不穩定窗口。若實際量為零,百分比沒有合適分母,就記錄絕對件數,不要硬套百分比。排班變動後,仍用相同欄位追蹤一週,讓新舊結果可以比較。
下一步,先整理最近幾週每十五分鐘的到件數、案件類型與客服實際處理分鐘,挑一個常出現的尖峰班試算,再依等待和未結案件調整。若你也想了解客服流程相關資訊,可前往 ReplyBot 官網。